8. Autoenkodery
Autoenkodery (autokodery) są to takie typy sieci neuronowych, które przekształcają dane wejściowe do postaci skróconej (skompresowanej, latentnej), a następnie je z tej postaci odtwarzają (rekonstruują). Sieci te składają się z dwóch części: enkodera i dekodera.
Enkoder (kompresor) przekształca dane wejściowe w skompresowaną reprezentację o niższej wymiarowości, zwaną warstwą latentną.
Dekoder (dekompresor) stara się na podstawie danych uzyskanych z warstwy latentnej jak najwierniej zrekonstruować pierwotne dane wejściowe, tak aby funkcja straty przyjmowała jak najniższą wartość.
Warstwa latentna (ang. bottleneck layer) jest kluczowym elementem autoenkodera i zmusza sieć do zidentyfikowania przez nią istotnych cech danych wejściowych.
Autoenkodery uczą się reprezentacji danych w sposób nienadzorowany, a więc nie wymagają etykiet podczas procesu uczenia. Sieć sama odkrywa struktury i wzorce w danych wejściowych, ucząc się kompresować i rekonstruować informacje.
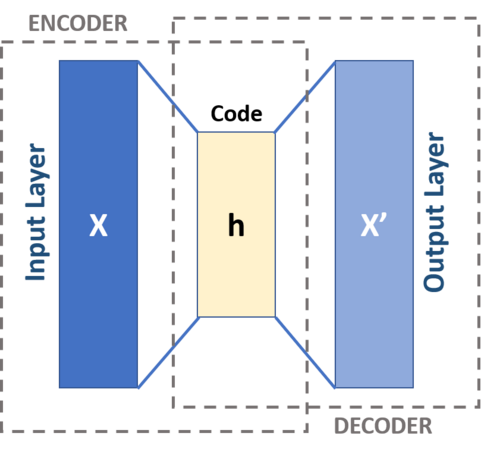
Rysunek 8.1. Schemat autoenkodera (źródło: Wikipedia, https://pl.wikipedia.org/wiki/Autoenkoder)
Note
Prawidłowym tłumaczeniem angielskiego słowa autoencoder jest autokoder. Będę jednak używać sformułowania autoenkoder, ponieważ przyjęło się ono w literaturze dotyczącej sieci neuronowych.
8.1. Klasa bazowa autoenkodera
W dalszej części rozdziału przedstawię dwie przykładowe implementacje autoenkoderów w C# z wykorzystaniem naszej biblioteki NeuralNetworks:
- autoenkodera składającego się z warstw gęstych oraz
- autoenkodera składającego się z warstw konwolucyjnych.
Oba modele zostaną oparte na klasie bazowej AutoencoderModel<T>, przedstawionej poniżej.
Dwie wyróżnione właściwości - BottleneckLayer i FirstDecoderLayer - reprezentują odpowiednio warstwę latentną oraz pierwszą warstwę dekodera.
public abstract class AutoencoderModel<T>(Loss<T>? defaultLossFunction, SeededRandom? random, string? modelFilePath)
    : BaseModel<T, T>(defaultLossFunction, random, modelFilePath)
    where T : notnull
{
    protected DenseLayer? BottleneckLayer { get; set; }

    protected DenseLayer? FirstDecoderLayer { get; set; }

    public float[,] GetEncodedRepresentation()
    {
        return BottleneckLayer?.Output
            ?? throw new InvalidOperationException("Bottleneck layer output is not available.");
    }

    public T Decode(float[,] encoded)
    {
        return FirstDecoderLayer is null
            ? throw new InvalidOperationException("Decoder layer is not initialized.")
            : InferFromLayer(FirstDecoderLayer, encoded);
    }

    public Operation GetBottleneckActivationFunction()
    {
        return BottleneckLayer?.GetActivationFunction()
            ?? throw new InvalidOperationException("Bottleneck layer is not initialized.");
    }
}
Listing 8.1. Definicja klasy bazowej autoenkodera
8.2. Autoenkodery z warstwami gęstymi
Poniżej przedstawiłem przykład implementacji autoenkodera z warstwami gęstymi. Model ten dziedziczy po powyższej klasie bazowej AutoencoderModel. Składa się on z (oznaczonych odpowiednimi liniami komentarzy) warstw enkodera, warstw dekodera oraz warstwy latentnej. W przykładzie tym zastosowano Leaky ReLU, Softsign i Tanh jako funkcje aktywacji oraz MSE (średni błąd kwadratowy) jako funkcję straty.
internal class AutoencoderDenseModel(int bottleneckDim, SeededRandom? random, string? modelFilePath = null)
    : AutoencoderModel<float[,]>(new MeanSquaredErrorLoss(MseReduction.ElementMean), random, modelFilePath)
{
    protected override LayerListBuilder<float[,], float[,]> CreateLayerListBuilder()
    {
        ParamInitializer initializer = new GlorotInitializer(Random);

        return
            // Encoder layers
            AddLayer(new DenseLayer(178, new LeakyReLU2D(), initializer))
            .AddLayer(new DenseLayer(46, new LeakyReLU2D(), initializer))

            // Bottleneck
            .AddLayer(BottleneckLayer = new DenseLayer(bottleneckDim, new Softsign(), initializer))

            // Decoder layers
            .AddLayer(FirstDecoderLayer = new DenseLayer(46, new LeakyReLU2D(), initializer))
            .AddLayer(new DenseLayer(178, new LeakyReLU2D(), initializer))
            .AddLayer(new DenseLayer(784, new Tanh2D(), initializer));
    }
}
Listing 8.2. Definicja modelu autoenkodera z warstwami gęstymi
Note
Powyższy kod w pełnej wersji znajduje się na GitHub.
Trzy poniższe warstwy:
new DenseLayer(178, new LeakyReLU2D(), initializer)
new DenseLayer(46, new LeakyReLU2D(), initializer)
new DenseLayer(bottleneckDim, new Softsign(), initializer)
przekształcają dane wejściowe ze zbioru MNIST o wymiarze 784 (28x28) na reprezentację latentną o wymiarze bottleneckDim. W dalszej części rozdziału zobaczymy jak wartości zmiennej bottleneckDim (5, 10, 15) wpływają na jakość rekonstrukcji danych wejściowych.
Wartości wyjściowe warstwy latentnej, po przejściu przez powższe 3 warstwy, otrzymano stosując Softsign jako funkcję aktywacji. Funkcja ta przyjmuje wartości z przedziału (-1, 1), co będzie nam ułatwiało późniejsze eksperymenty, polegające na generowaniu losowych reprezentacji latentnych i obserwowaniu, jak dekoder rekonstruuje dane wejściowe (sekcja 8.4.4.).
Wartości z przedziału (-1, 1) można również uzyskać za pomocą funkcji aktywacji Tanh i taka też funkcja pojawia się w przykładach, które można znaleźć w literaturze. Jednak z moich doświadczeń wynika, że lepsze rezultaty uzyskuje się stosując Softsign, szczególnie w przypadku autoenkoderów z wąskim gardłem. Może to wynikać z tego, że Softsign ma łagodniejsze nachylenie, co sprzyja stabilniejszemu uczeniu się reprezentacji latentnych. Polecam zapoznanie się z wykresami umieszczonymi w tym rozdziale.
8.3. Autoenkodery z warstwami konwolucyjnymi
Autoenkodery mogą również wykorzystywać warstwy konwolucyjne, co pozwala im lepiej uchwycić lokalne zależności w danych graficznych. Poniżej przedstawiono przykład implementacji autoenkodera z takimi właśnie warstwami.
internal class AutoencoderConvModel(int bottleneckDim, SeededRandom? random, string? modelFilePath = null)
    : AutoencoderModel<float[,,,]>(new MeanSquaredErrorLoss4D(MseReduction.ElementMean), random, modelFilePath)
{

    protected override LayerListBuilder<float[,,,], float[,,,]> CreateLayerListBuilder()
    {
        ParamInitializer initializer = new GlorotInitializer(Random);

        return
            // Encoder layers
            AddLayer(new Conv2DLayer(
                kernels: 32,
                kernelHeight: 3,
                kernelWidth: 3,
                activationFunction: new Tanh4D(),
                paramInitializer: initializer
            ))
            .AddLayer(new MaxPooling2DLayer(2, 2))
            .AddLayer(new FlattenLayer())

            // Bottleneck
            .AddLayer(BottleneckLayer = new DenseLayer(bottleneckDim, new Softsign(), initializer))

            // Decoder layers
            .AddLayer(FirstDecoderLayer = new DenseLayer(32 * 14 * 14, new LeakyReLU2D(), initializer))
            .AddLayer(new UnflattenLayer(32, 14, 14))
            .AddLayer(new Upsample2DLayer(2, 2))
            .AddLayer(new Conv2DLayer(
                kernels: 1,
                kernelHeight: 3,
                kernelWidth: 3,
                activationFunction: new Tanh4D(),
                paramInitializer: initializer
            ));
    }
}
Listing 8.3. Definicja modelu autoenkodera z warstwami konwolucyjnymi
Note
Powyższy kod w pełnej wersji znajduje się na GitHub.
Analizując modele z listingów 8.1., 8.2. i 8.3. można zauważyć, że format danych wejściowych (wektor, tablica wielowymiarowa) jest zawsze taki sam jak danych wyjściowych. Warstwa latentna (bottleneck) natomiast jest zawsze jednowymiarowa (wektor).
8.4. Proces i wyniki trenowania
Proces trenowania autoenkoderów polega na minimalizacji funkcji straty, która w przypadku naszych autoenkoderów jest średnim błędem kwadratowym MSE pomiędzy danymi wejściowymi a ich rekonstrukcją. Kody źródłowe implementujące ten proces znajdują się na GitHub tu (warstwy gęste) oraz tu (konwolucja).
Minimalizowaną podczas treningu funkcję straty można zapisać jako (por. wzór 1.8)
gdzie
Symbol \(x\) oznacza dane wejściowe, natomiast \(x'\) — ich rekonstrukcję uzyskaną przez autoenkoder. Funkcja \(f\) reprezentuje enkoder, który mapuje dane wejściowe na reprezentację latentną, a funkcja \(g\) reprezentuje dekoder, który na podstawie tej reprezentacji odtwarza dane wejściowe.
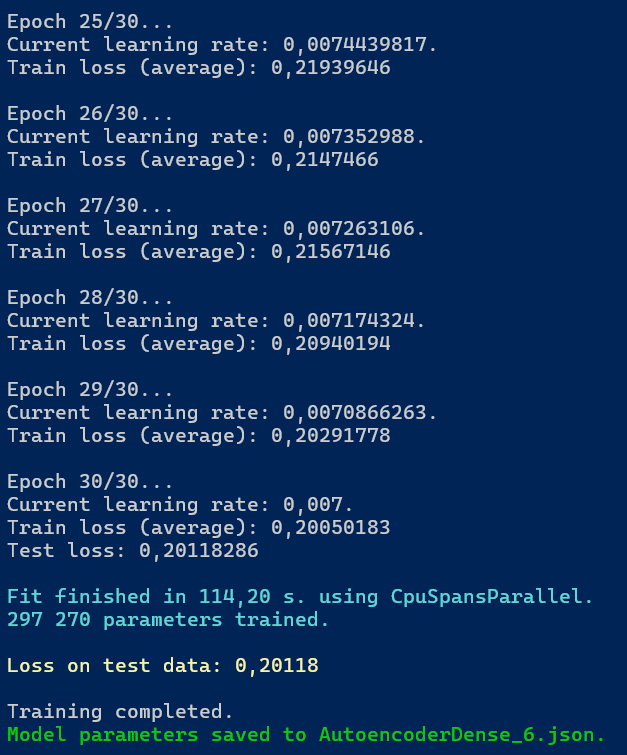
Rysunek 8.2. Przykładowy screen z procesu trenowania autoenkodera
8.4.1. Rekonstrukcja danych wejściowych
Poniższe dwie tabele przedstawiają wyniki trenowania wyżej opisanych autoenkoderów. Zamieszczone w tych tabelach grafiki prezentują rekonstrukcje dokonane przez wytrenowaną sieć dla różnych wymiarów warstwy latentnej w odniesieniu do oryginalnych obrazów wejściowych.
| Wymiar warstwy latentnej | Rekonstruowane obrazy (warstwy gęste) |
|---|---|
| 5 |       |
| 10 |       |
| 15 |       |
| Oryginał | 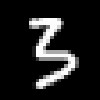 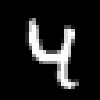 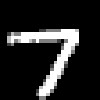 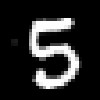   |
Tabela 8.1. Wyniki trenowania autoenkodera z warstwami gęstymi (epochs: 30, batch size: 400, learning rate: od 1e-2 do 7e-3)
| Wymiar warstwy latentnej | Rekonstruowane obrazy (warstwy konwolucyjne) |
|---|---|
| 5 |       |
| 10 |       |
| 15 |       |
| Oryginał | 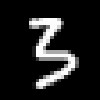 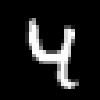 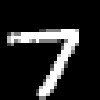 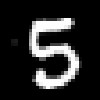   |
Tabela 8.2. Wyniki trenowania autoenkodera z warstwami konwolucyjnymi (epochs: 10, batch size: 200, learning rate: od 1e-2 do 5e-4)
Widzimy, że im większy wymiar warstwy latentnej, tym lepsza jakość rekonstruowanych obrazów. Dla niskich wartości wymiaru latentnego rekonstrukcje są nieco dokładniejsze w przypadku autoenkodera z warstwami konwolucyjnymi.
Poniżej przedstawiono fragment kodu odpowiedzialnego za wczytanie modelu autoenkodera (z warstwami gęstymi) oraz rekonstrukcję obrazów z danych treningowych (choć zapewne powinny to być dane testowe - na razie zachowajmy ten fragment do późniejszej modyfikacji).
AutoencoderDenseModel model = new(bottleneckDim, null, modelPath);
float[,] xTrain = LoadTrainingData();

// Normalize the pixel values from [0, 255] to [-1, 1].
xTrain.ScaleToInPlace(-1f, 1f);

float[,] reconstructedImages = model.Forward(xTrain, true);

// Rescale the pixel values back to [0, 255] for visualization purposes.
reconstructedImages.ScaleToInPlace(0f, 255f);
Listing 8.4. Rekonstrukcja obrazów przy użyciu wczytanego modelu autoenkodera
8.4.2. Wykresy t-SNE
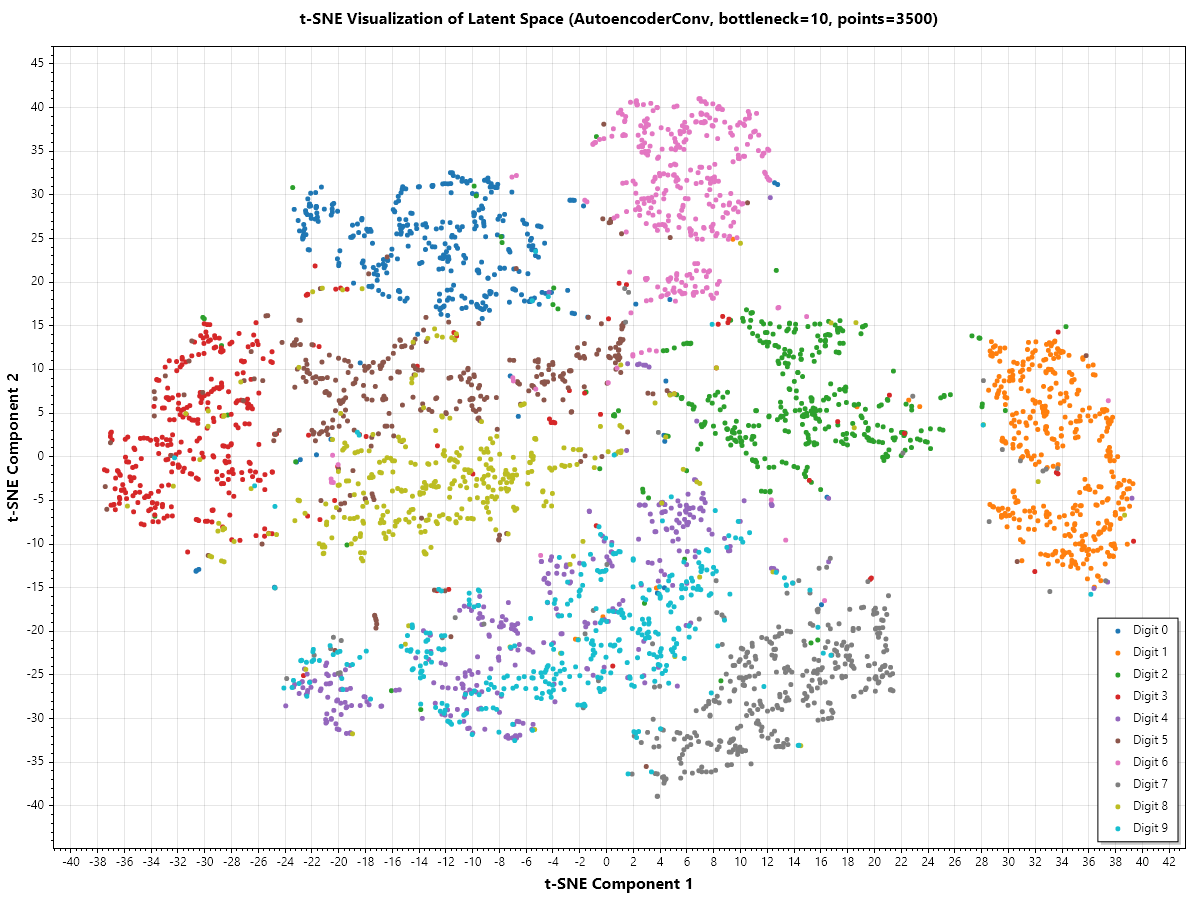
Technika t-SNE (t-Distributed Stochastic Neighbor Embedding) jest metodą nieliniowej redukcji wymiarowości, wykorzystywaną przede wszystkim do wizualizacji danych wielowymiarowych w przestrzeni dwu- lub trójwymiarowej. Na wejściu przyjmuje zbiór punktów reprezentowanych w przestrzeni o wysokiej liczbie wymiarów, np. wektorów z warstwy latentnej autoenkodera lub wektorów osadzeń (embeddings). Następnie, w procesie optymalizacji iteracyjnej, wyznacza ich reprezentację w przestrzeni o niższej wymiarowości, starając się zachować lokalne relacje między punktami, w szczególności ich sąsiedztwo. Należy przy tym pamiętać, że t-SNE nie zachowuje (bo nie jest to możliwe) wiernie wszystkich odległości między punktami, a odległości i układ skupisk widocznych na wizualizacji nie muszą odzwierciedlać rzeczywistych zależności ilościowych w przestrzeni wejściowej.
Do techniki tej powrócimy w dalszych rozdziałach, omawiając redukcję wymiarowości wektorów osadzeń / wektorów cech. W kontekście autoenkoderów t-SNE może służyć do wizualnej oceny struktury reprezentacji w przestrzeni latentnej, w tym do sprawdzenia, czy punkty należące do różnych klas tworzą odrębne skupiska. Taka wizualizacja pozwala wstępnie ocenić, na ile reprezentacje latentne ujawniają strukturę związaną z przynależnością do klas.
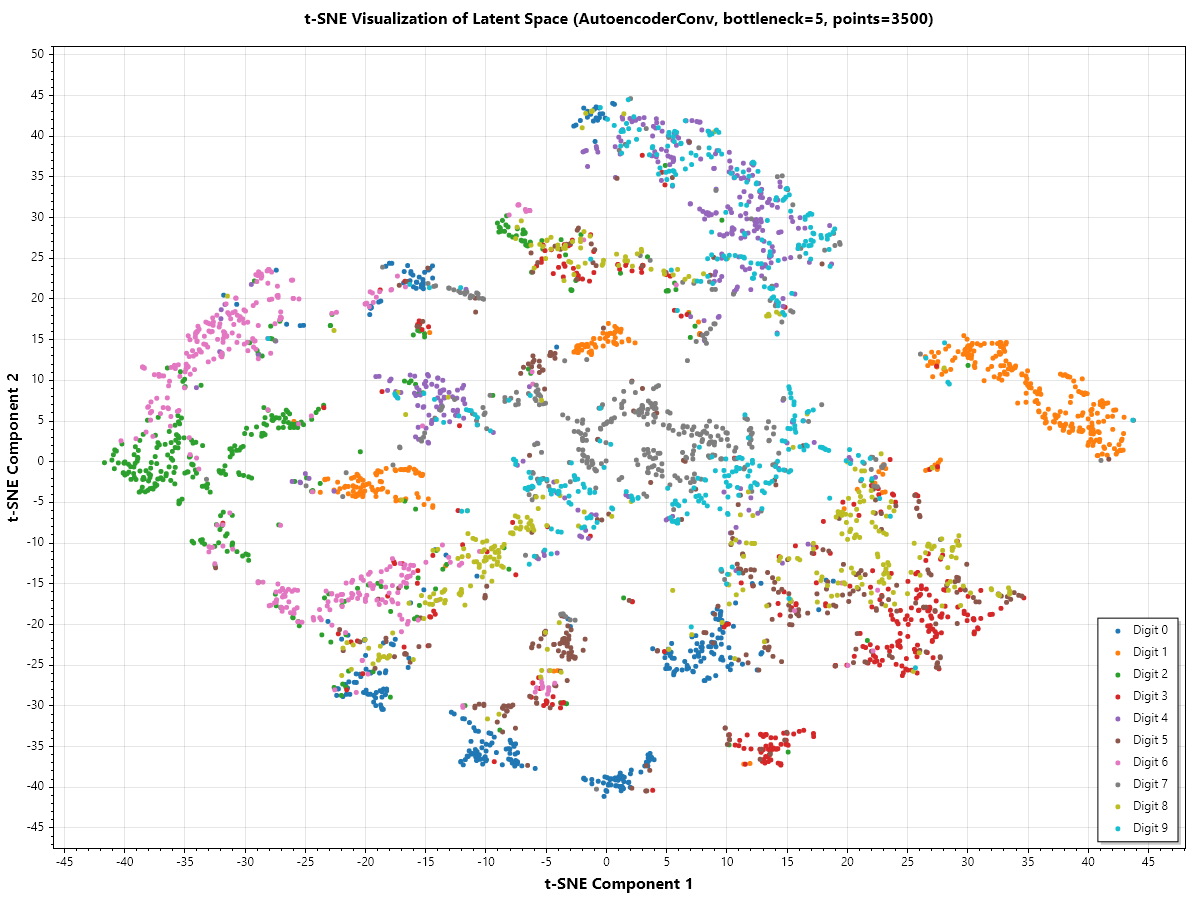
W poniższej tabeli przedstawiono wykresy t-SNE dla różnych wymiarów warstwy latentnej (5, 10, 15) dla obu omówionych typów enkoderów (warstwy gęste i konwolucyjne). Widzimy, że wraz ze wzrostem wymiaru warstwy latentnej klastry stają się lepiej i sensowniej rozmieszczone. Dla wyższych wymiarów poszczególne cyfry (oznaczone różnymi kolorami opisanymi w legendzie) są pogrupowane w wyraźne klastry, co świadczy o tym, że autoenkoder skutecznie oddziela różne klasy danych w przestrzeni warstwy latentnej.
| Wymiar warstwy latentnej | Wykres t-SNE (warstwy gęste) | Wykres t-SNE (warstwy konwolucyjne) |
|---|---|---|
| 5 | 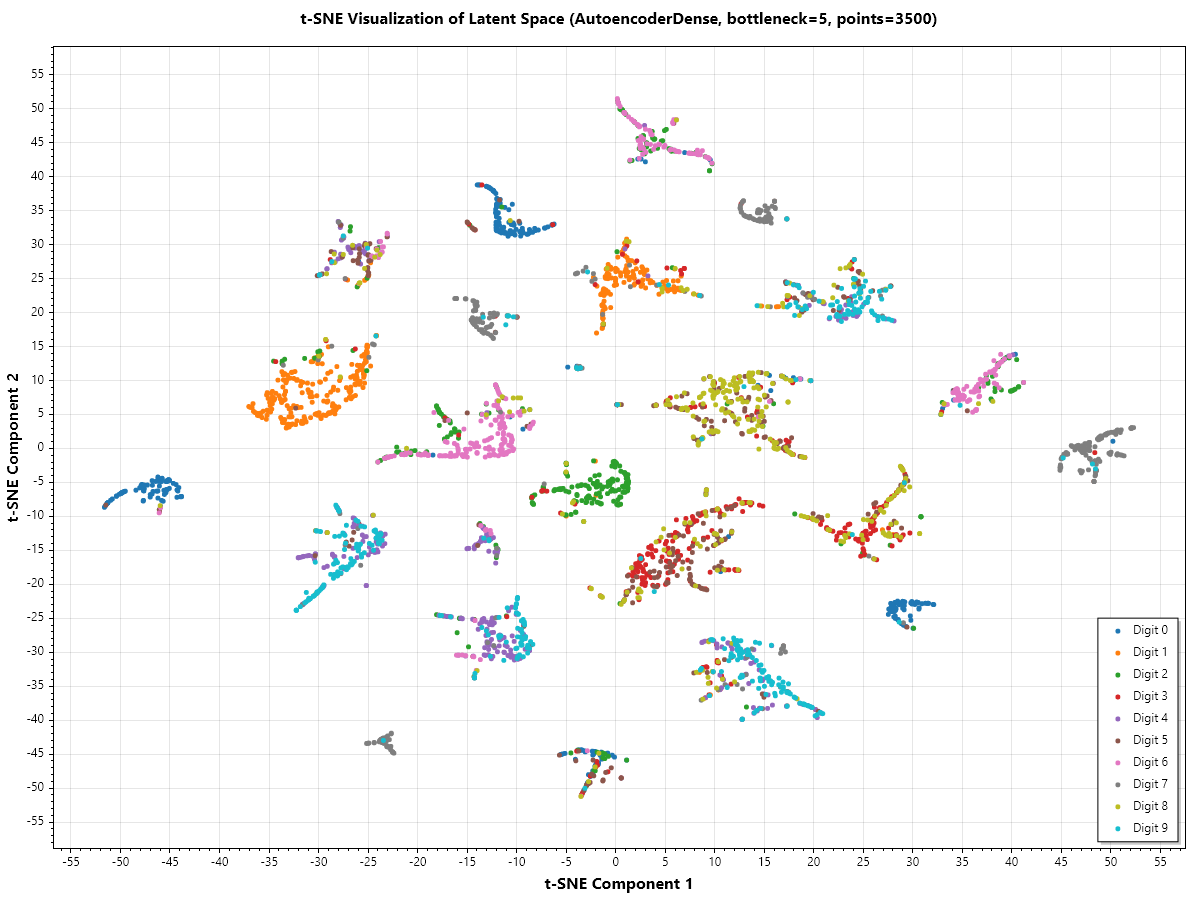 |
 |
| 10 | 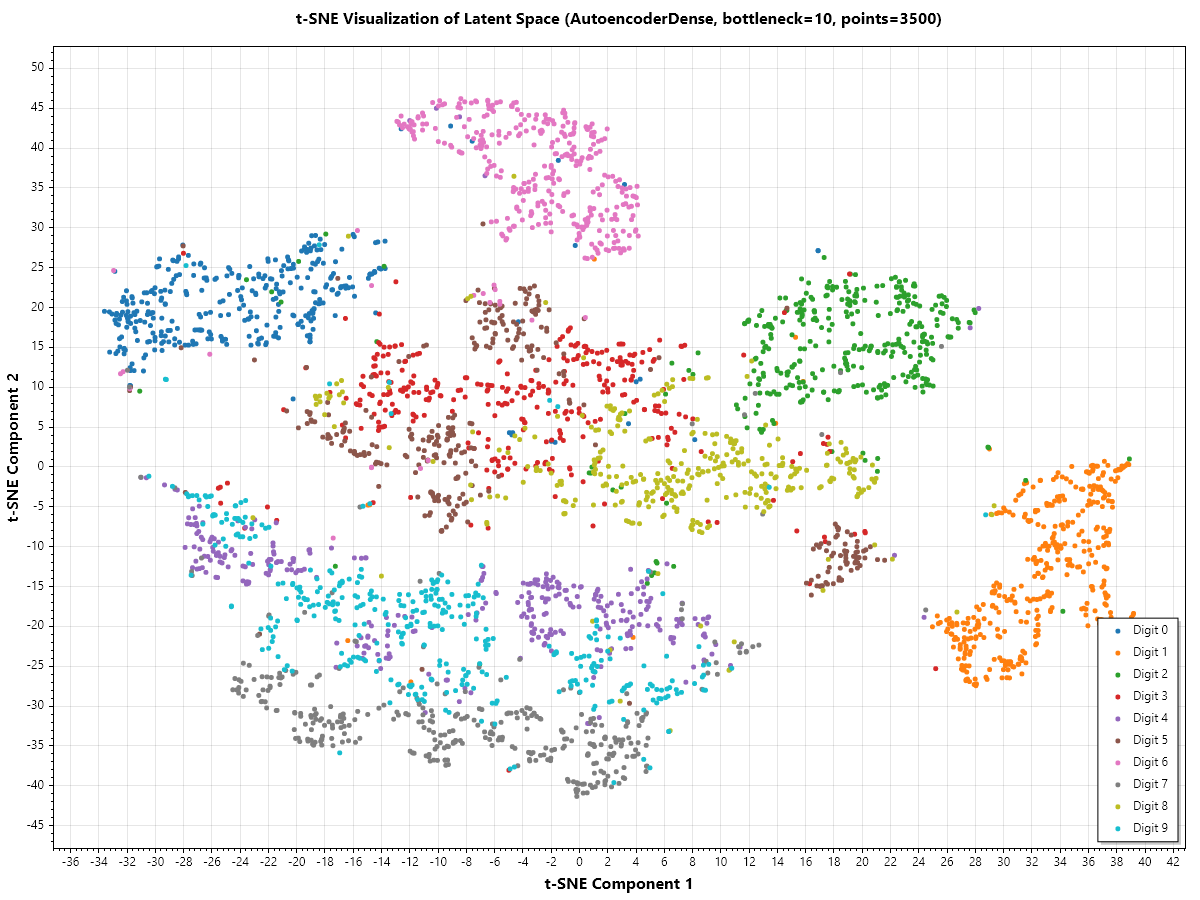 |
 |
| 15 | 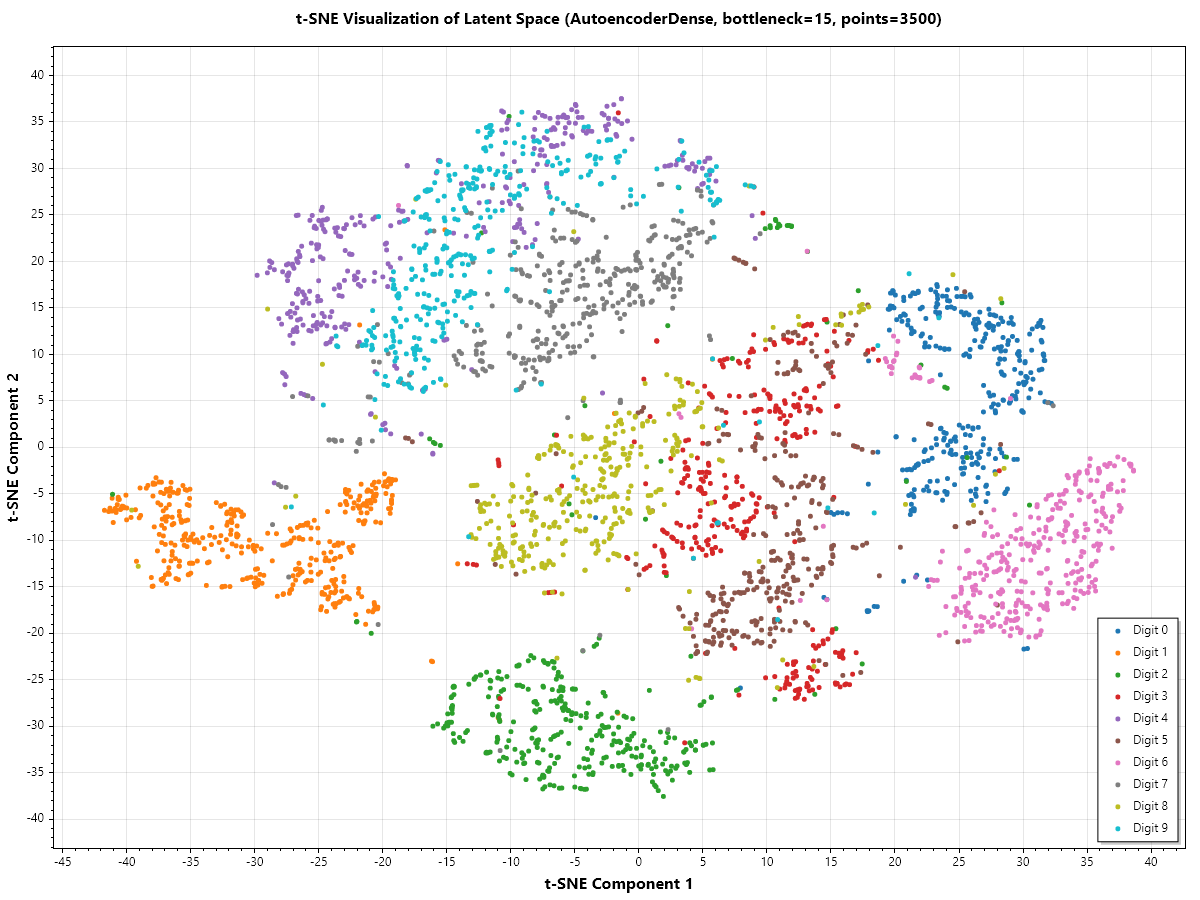 |
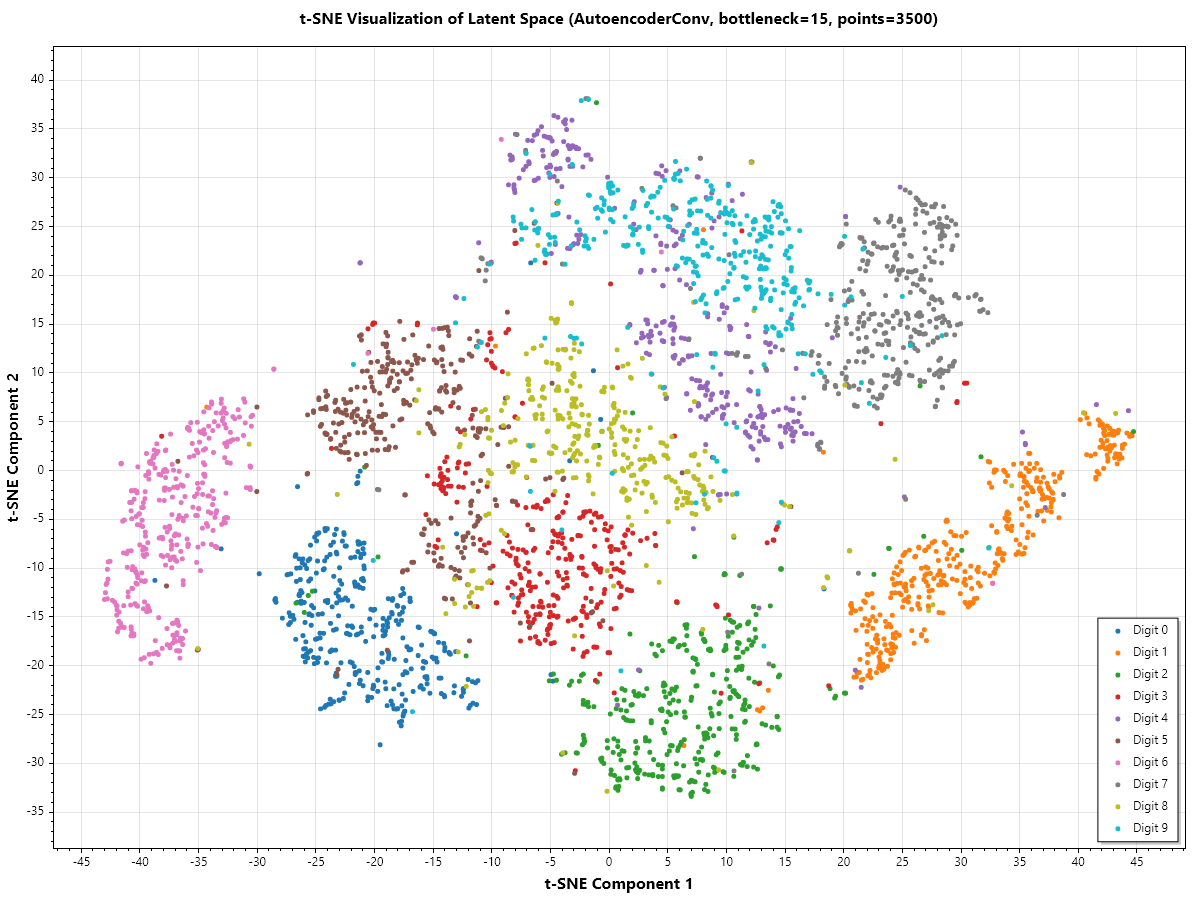 |
Tabela 8.3. Wykresy t-SNE dla różnych wymiarów warstwy latentnej
Do utworzenia powyższych wykresów wykorzystaliśmy klasę TSNE z biblioteki Accord.NET. Jej kod źródłowy znajduje się tutaj. Poniższy listing przedstawia przykładowy sposób jej użycia.
TSNE tsne = new()
{
    NumberOfOutputs = 2,
    Perplexity = 30
};

double[][] reduced = tsne.Transform(encodedDouble);
Listing 8.5. Przykładowe użycie klasy TSNE
8.4.3. Histogramy wartości warstwy latentnej
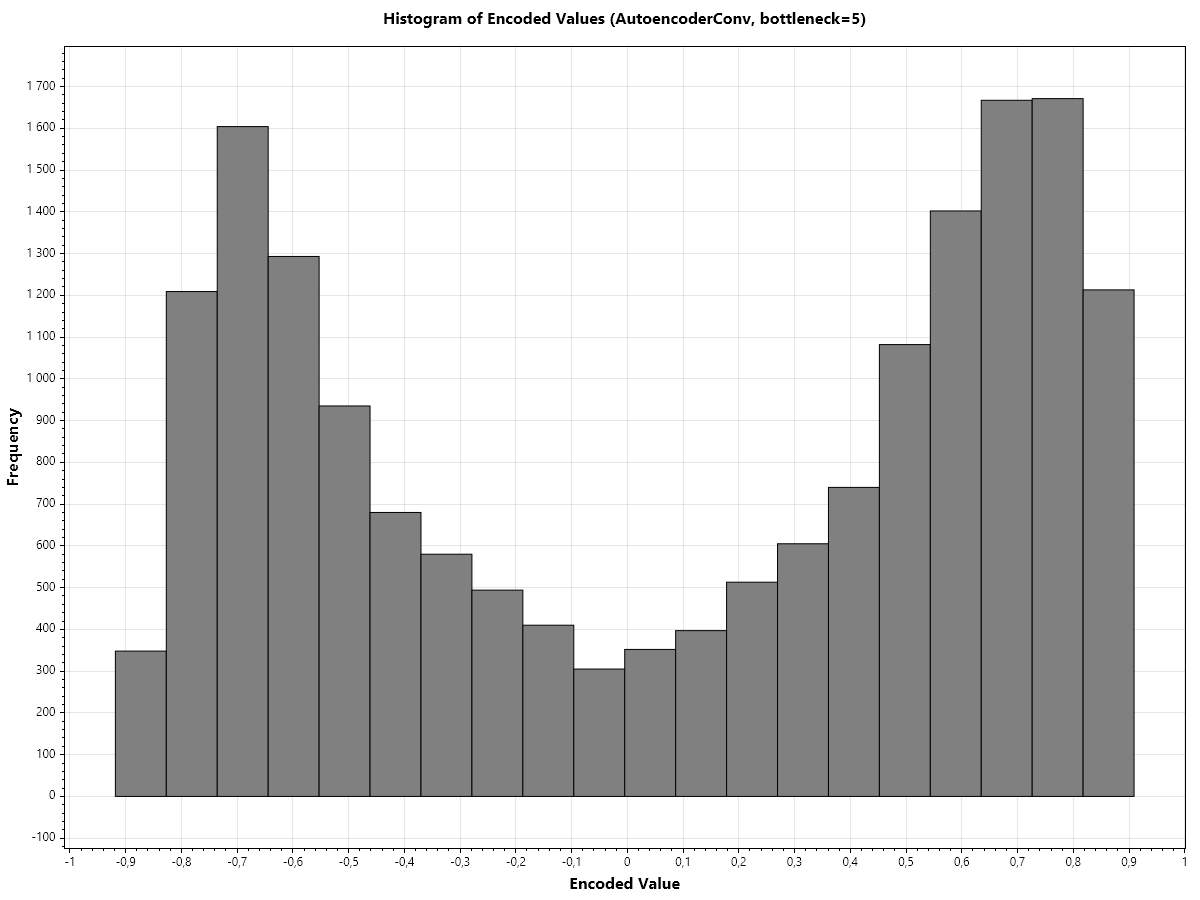
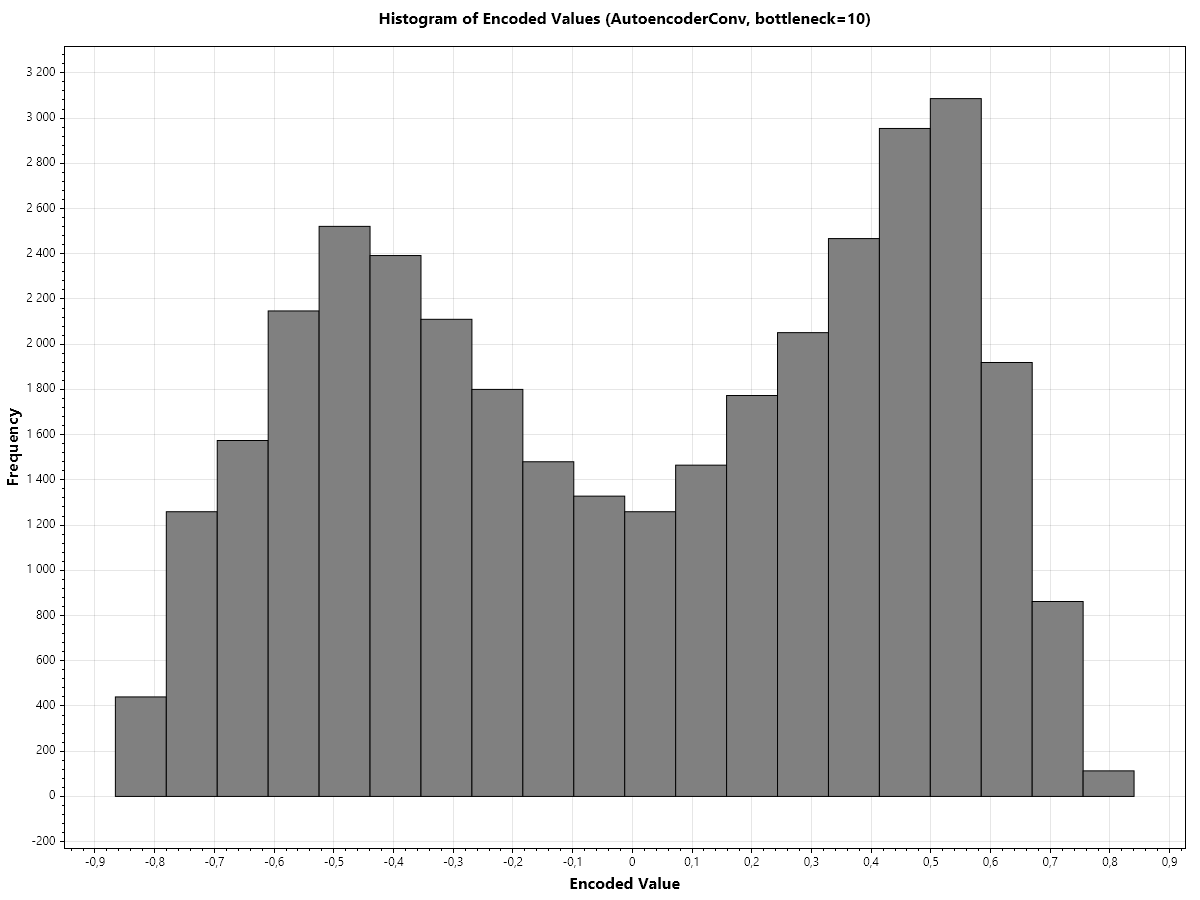
W naszych przykładach warstwa latentna przyjmuje wartości z przedziału (-1, 1), co jest wynikiem zastosowania funkcji aktywacji Softsign. Na poniższych wykresach widzimy rozkład wartości w tym zakresie. Najgorszy rozkład wartości (dwa wyraźne piki w okolicach -1 i 1) obserwujemy dla 5-wymiarowej warstwy latentnej w sieci gęstej. Rozkład ten staje się coraz bardziej równomierny wraz ze wzrostem wymiaru warstwy latentnej, ale nadal obserwujemy piki w okolicach -0,5 i 0,5. Dla warstw konwolucyjnych występuje podobny trend, choć rozkład wartości jest nieco bardziej równomierny już dla 5-wymiarowej warstwy latentnej.
W miarę zwiększania wymiaru warstwy latentnej histogramy stają się coraz bardziej płaskie, co wskazuje na lepsze wykorzystanie przestrzeni latentnej przez autoenkoder konwolucyjny.
| Wymiar warstwy latentnej | Histogram wartości (warstwy gęste) | Histogram wartości (warstwy konwolucyjne) |
|---|---|---|
| 5 | 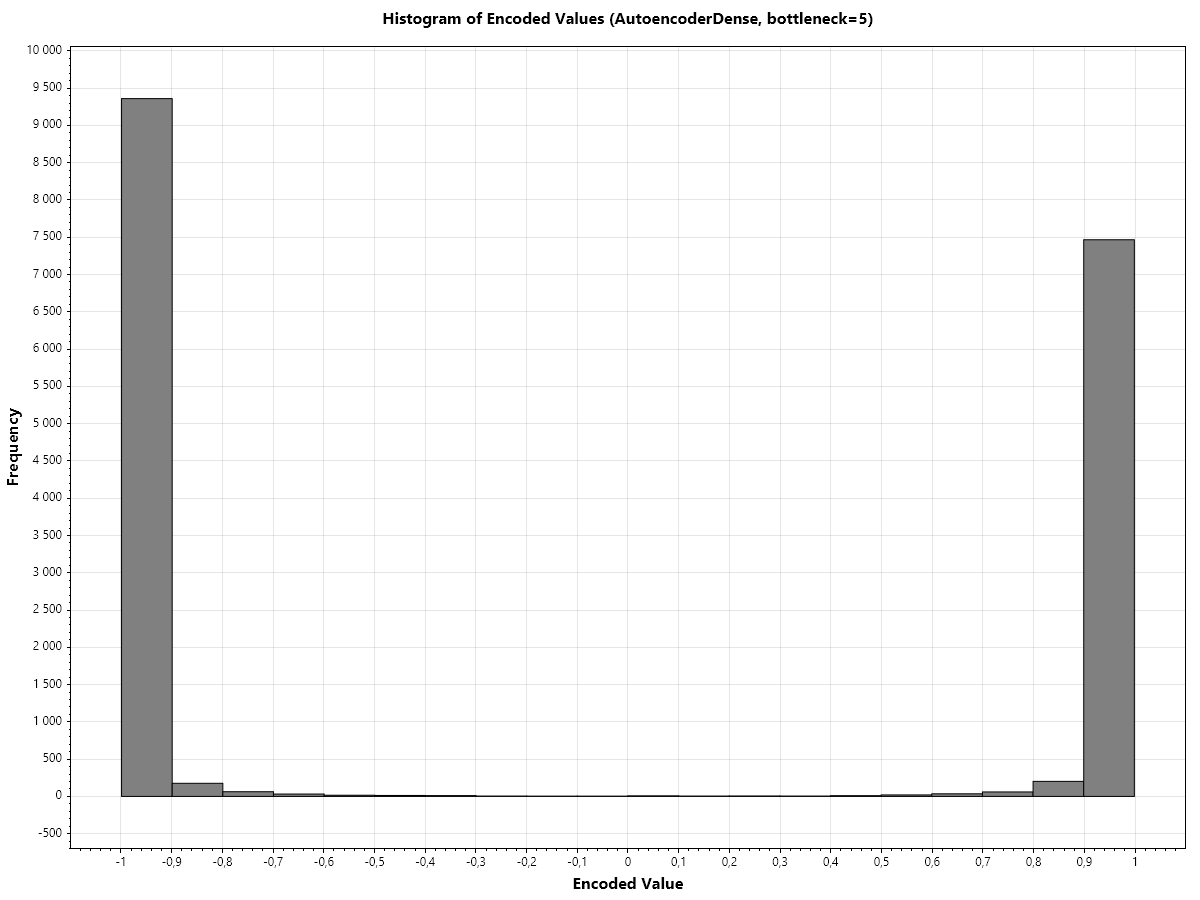 |
 |
| 10 | 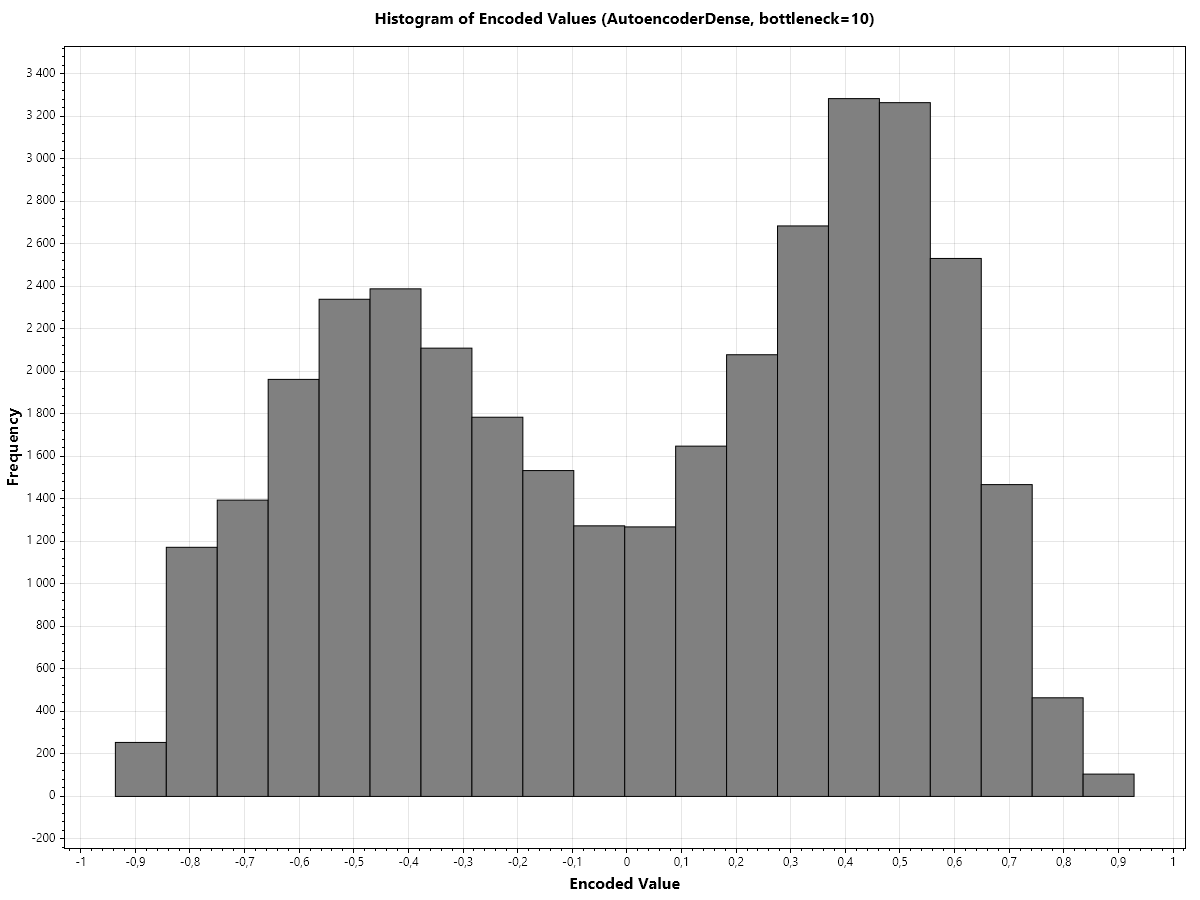 |
 |
| 15 | 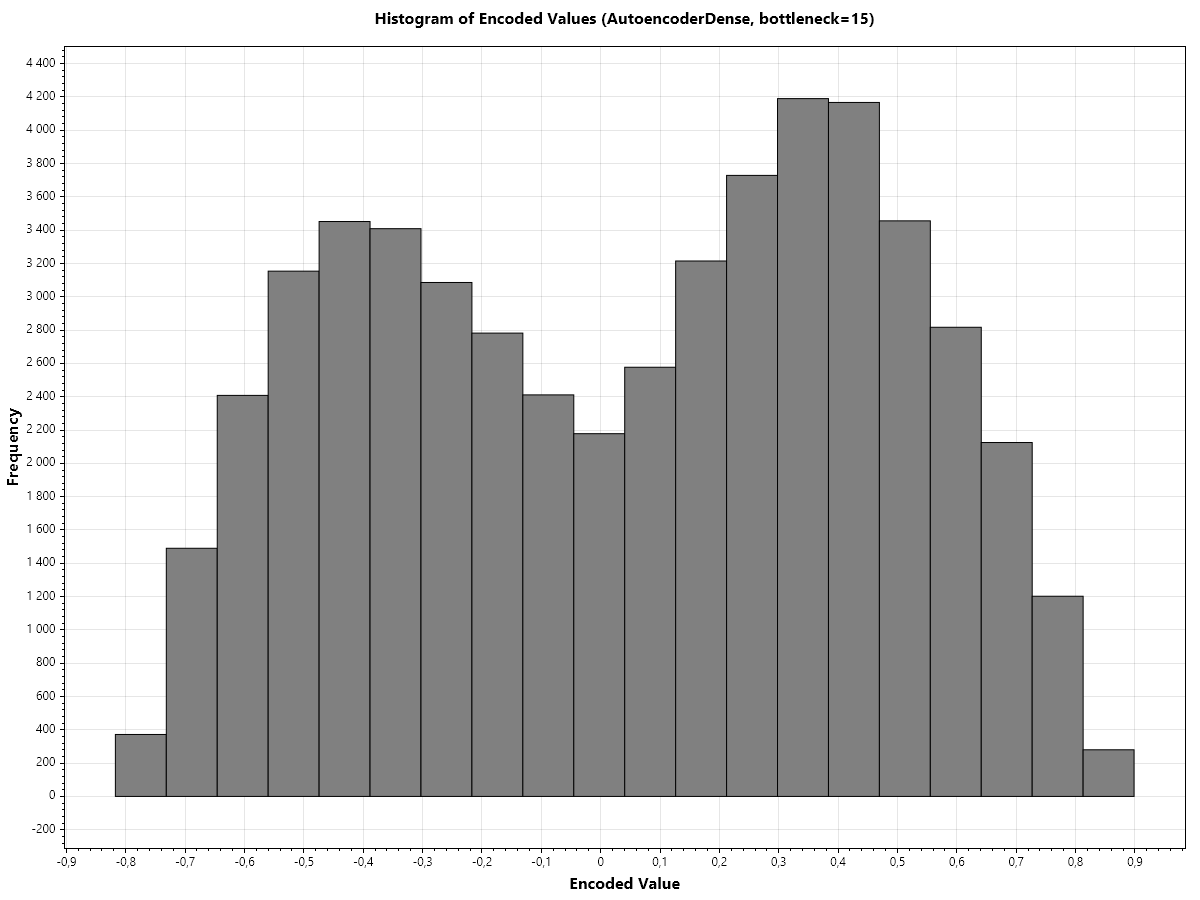 |
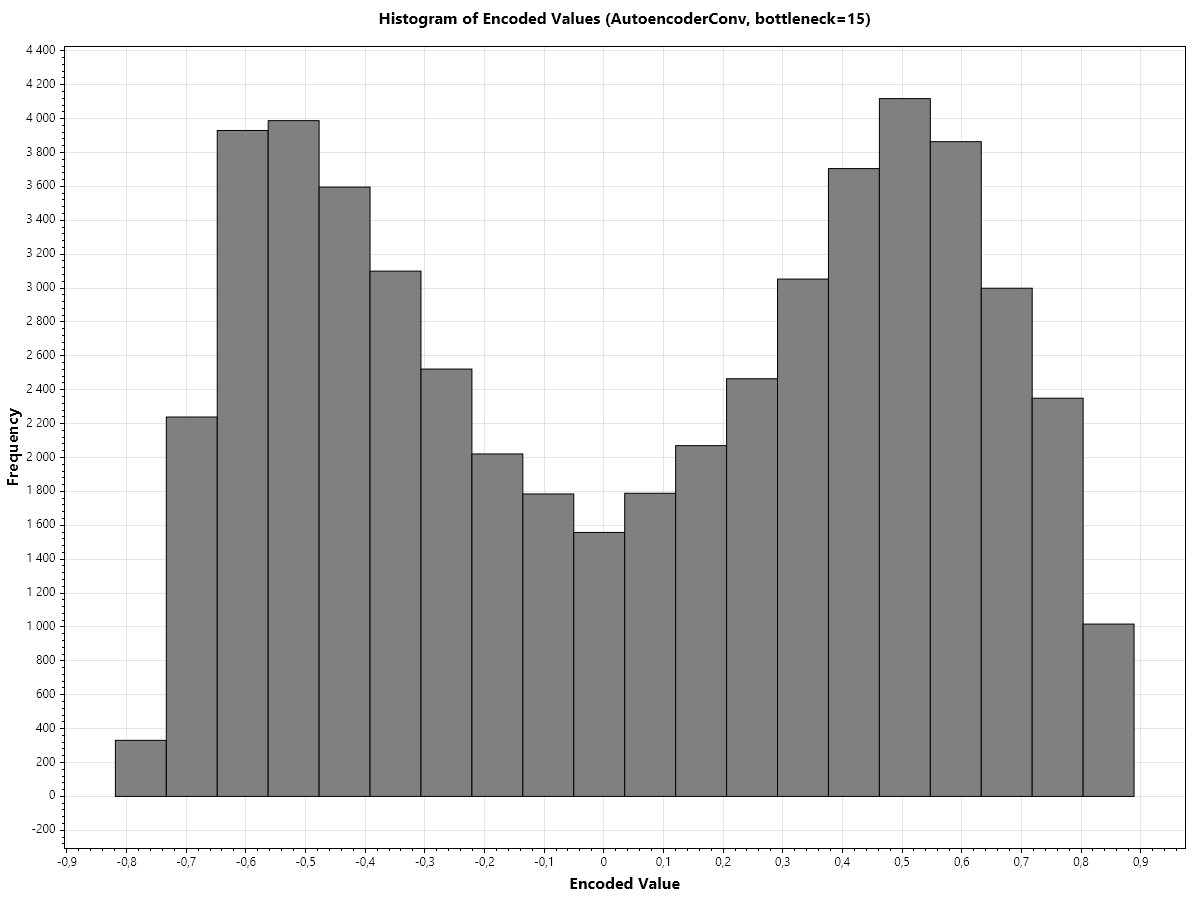 |
Tabela 8.4. Histogramy wartości warstwy latentnej
8.4.4. Generowanie losowych próbek
W tej sekcji dowiemy się jak wyglądają obrazy powstałe w wyniku dekodowania losowo wygenerowanych próbek z przestrzeni latentnej. Próbki te są tworzone poprzez losowanie wartości z przedziału [-1, 1) dla każdego wymiaru warstwy latentnej, a następnie są one dekodowane za pomocą części "dekoderowej" autoenkodera, jak na poniższym listingu:
Random random = new(randomSeed);
float[,] randomEncoded = new float[imageCount, bottleneckDim];
for (int i = 0; i < imageCount; i++)
{
    for (int j = 0; j < bottleneckDim; j++)
    {
        randomEncoded[i, j] = (float)(random.NextDouble() * 2 - 1); // Random values in [-1, 1)
    }
}
float[,] randomlyGeneratedImages = model.Decode(randomEncoded);
Listing 8.6. Generowanie losowych próbek z przestrzeni latentnej i dekodowanie ich za pomocą autoenkodera
Poniższe przykłady pokazują wygenerowane obrazy dla różnych wymiarów warstwy latentnej w sieciach gęstych i konwolucyjnych.
| Wymiar warstwy latentnej | Losowe próbki (warstwy gęste) | Losowe próbki (warstwy konwolucyjne) |
|---|---|---|
| 5 |      |
     |
| 10 |      |
     |
| 15 |      |
     |
Tabela 8.5. Losowe próbki wygenerowane z przestrzeni latentnej
Co ciekawe, im wyższy wymiar warstwy latentnej, tym rzadziej generowane obrazy przypominają rzeczywiste cyfry. Można to zapewne tłumaczyć tym, że w większych wymiarach przestrzeń latentna nie jest w pełni wykorzystana do reprezentowania wszystkich wymaganych wariantów danych i koduje również obrazy, które nie odpowiadają rzeczywistym danym.
8.4.5. "Doprawienie" modelu autoenkodera
Jak zobaczyliśmy powyżej, model złożony z warstw gęstych produkuje dla rozmiaru warstwy latentnej równego 5 dalece niezadowalające wyniki w zakresie generowania obrazów. Również wykres histogramu oraz t-SNE wskazują na jego słabe działanie. Wystarczy jednak wprowadzić do naszego modelu małe zmiany, aby znacząco poprawić jego jakość bez zmiany rozmiaru warstwy latentnej. Modyfikacje te przedstawiłem na poniższym listingu.
protected override LayerListBuilder<float[,], float[,]> CreateLayerListBuilder()
{
    ParamInitializer initializer = new GlorotInitializer(Random);

    CompositeRegularizer regularizer = new(
        new L2Regularizer(0.01f),
        new MaxNormRegularizer(2.8f)
    );

    Dropout2D dropout = new(0.95f, Random);

    return
        // Encoder
        AddLayer(new DenseLayer(178, new LeakyReLU2D(), initializer, dropout))
        .AddLayer(new DenseLayer(46, new LeakyReLU2D(), initializer))

        // Bottleneck
        .AddLayer(BottleneckLayer = new DenseLayer(bottleneckDim, new Softsign(), initializer, weightsRegularizer: regularizer))

        // Decoder
        .AddLayer(FirstDecoderLayer = new DenseLayer(46, new LeakyReLU2D(), initializer))
        .AddLayer(new DenseLayer(178, new LeakyReLU2D(), initializer))
        .AddLayer(new DenseLayer(784, new Tanh2D(), initializer));
}
Listing 8.7. Zmodyfikowany model autoenkodera z warstwami gęstymi
Po wprowadzeniu regularyzacji na wartwie latentnej oraz zastosowaniu dropout w jednej z warstw enkodera, jakość działania modelu poprawiła się znacząco, co widać na poniższych wykresach i wynikach generowania obrazów.
| Opis | Wykres |
|---|---|
| Histogram wartości w przestrzeni latentnej | 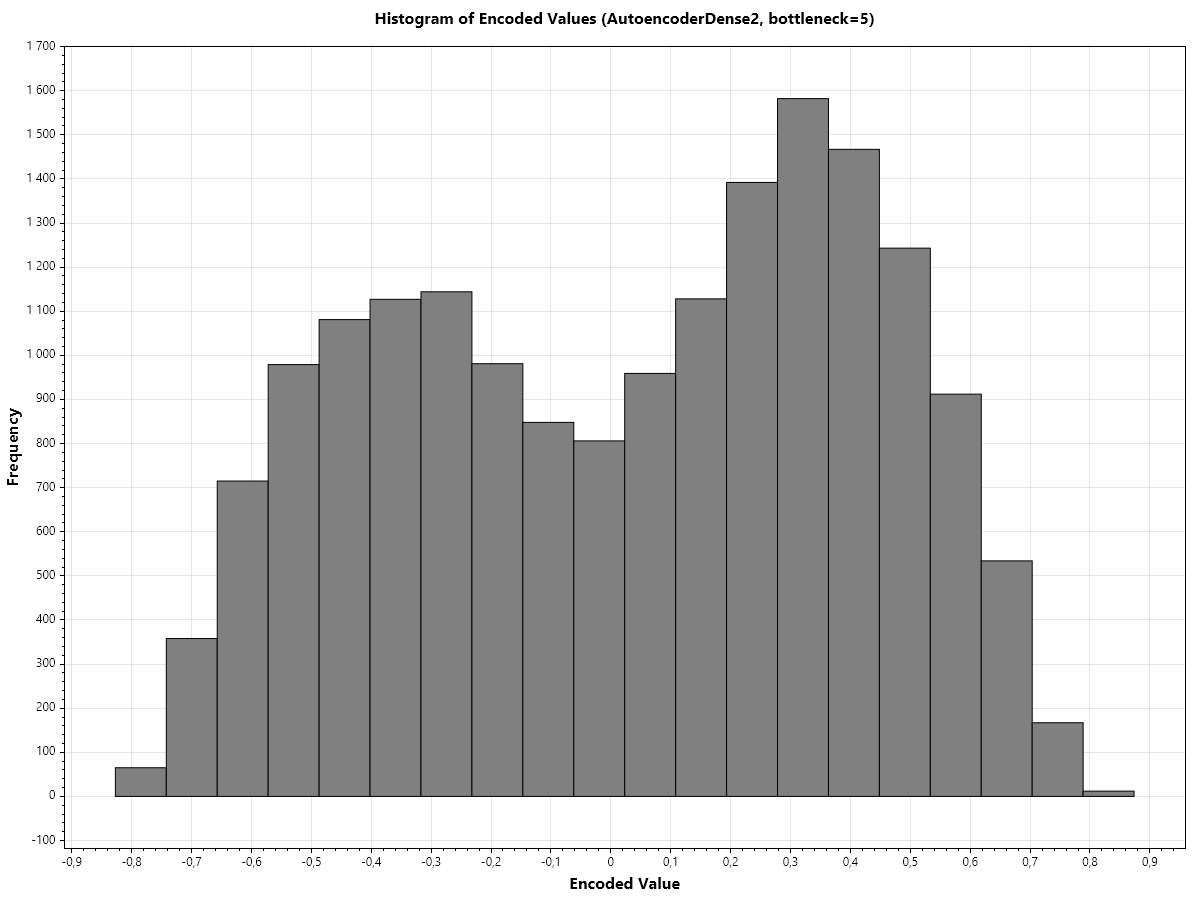 |
| Wizualizacja wartości w przestrzeni latentnej za pomocą t-SNE | 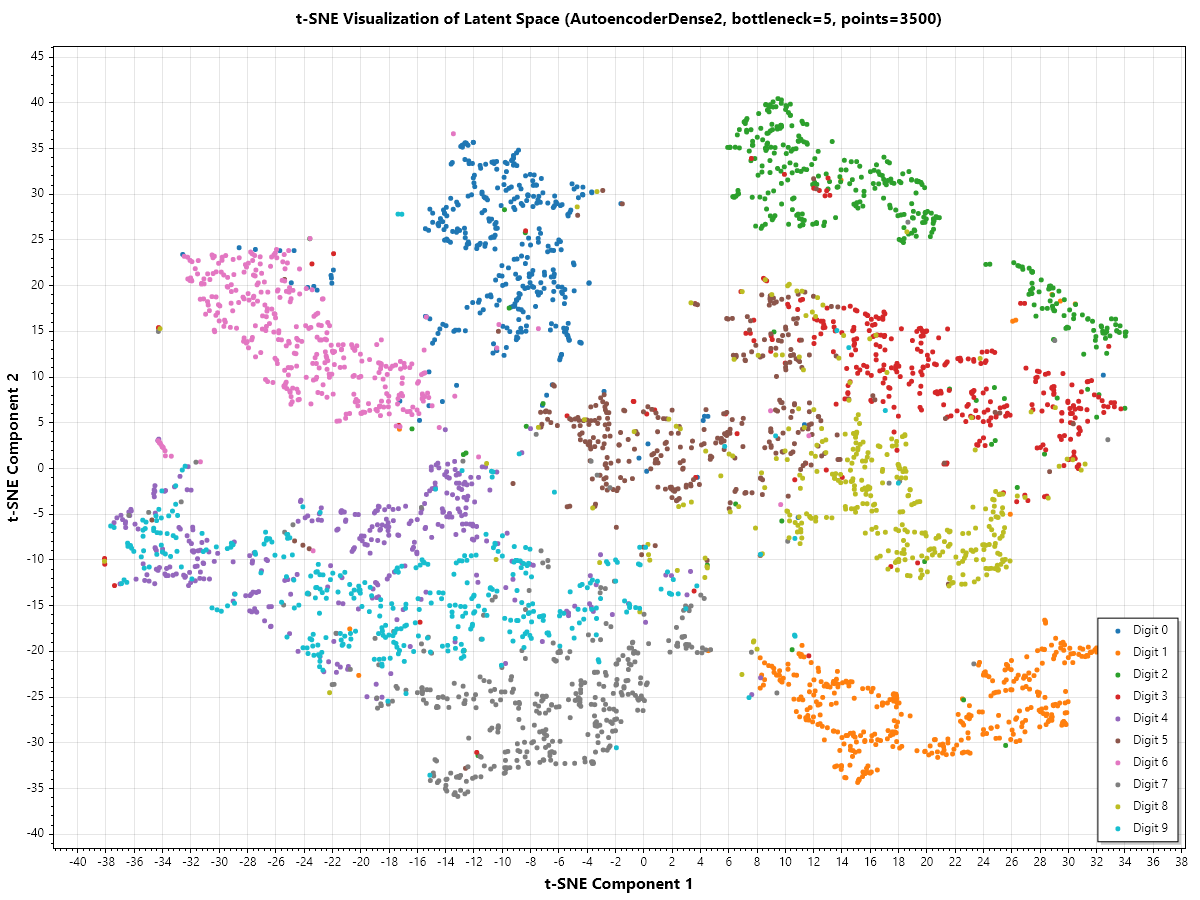 |
Tabela 8.6. Histogram i wizualizacja wartości w przestrzeni latentnej dla modelu z listingu 8.7
| Opis | Obrazy |
|---|---|
| Rekonstrukcja - model z listingu 8.2 (bez regularyzacji i dropout), wymiar warstwy latentnej = 5 | |
| Rekonstrukcja - model z listingu 8.7 (z regularyzacją i dropout), wymiar warstwy latentnej = 5 |       |
| Oryginał | |
Tabela 8.7. Porównanie jakości rekonstrukcji obrazów przez dwa różne modele autoenkoderów
8.5. Podsumowanie
W niniejszym rozdziale omówiłem koncepcję autoenkoderów, ich implementację w sieciach gęstych i konwolucyjnych oraz sposób wykorzystania przestrzeni latentnej do generowania nowych próbek danych. Przedstawiłem też wpływ wymiaru warstwy latentnej oraz zastosowania regularyzacji i dropoutu na jakość generowanych obrazów.
Created: 2026-05-15
Last modified: 2026-10-21
Title: 8. Autoenkodery
Tags: [C#] [Sieci neuronowe] [Biblioteka] [NeuralNetworks] [MNIST] [CNN] [Convolutional Neural Networks] [Autoencoders] [Autoenkodery]